


Datenmodell
ab 4.900 € netto
Für Projekte mit MVP-Charakter.
- ◆ Sauberes Schema auf PostgreSQL oder MySQL
- ◆ Umkehrbare Migrationen
- ◆ Backups mit Point-in-Time-Recovery
- ◆ Indizes für die wichtigsten Abfragen
MARCODES entwickelt Datenmodelle und Datenbank-Infrastrukturen, die heute schnell sind und in fünf Jahren immer noch performant - mit MySQL, PostgreSQL, Redis und Zeitreihen-Systemen, gezielt eingesetzt statt religiös ausgewählt.
Im Maschinenraum
Daten sind das Rückgrat jeder modernen Anwendung. Wir bauen Datenbank-Setups, die heute zuverlässig sind und morgen mit Ihrem Geschäft mitwachsen - ohne dass ein Refactoring den nächsten Quartalsplan sprengt.
In jeder Software-Architektur entscheiden zwei Dinge über die spätere Belastbarkeit: das Datenmodell und die Datenbank-Wahl. Eine gut entworfene Schema-Struktur löst Probleme, bevor sie entstehen - eine schlechte erzeugt sie über Jahre. Bei MARCODES sind wir Spezialisten für Datenmodellierung und entwickeln Datenbank-Setups, die sauber strukturiert, dokumentiert und auch in fünf Jahren noch wartbar sind.
Unsere Datenbank-Setups sind nicht religiös auf eine Engine festgelegt. Ob PostgreSQL für transaktionale Workloads, MySQL/MariaDB für klassische Webanwendungen, Redis für Caching und Queues oder TimescaleDB und InfluxDB für Zeitreihen - wir wählen die Engine nach Anwendungsfall, nicht nach Mode. Indexstrategien, Partitionierung, Replikation und Backup-Konzept gehören in dieselbe Architektur-Phase wie das Datenmodell.
Energie- und PropTech-Anbieter
MARCODES hat unsere Smart-Meter-Pipeline endlich so gebaut, dass auch das Jahres-Reporting in Sekunden steht - nicht in Minuten.
Häufige Fragen
PostgreSQL, MySQL, Time-Series, Document Store. Wir geben eine Meinung mit Begründung.
Engineering-Praxis
Schnell, sicher und skalierbar - unsere Datenbank-Architekturen sind auf Ihre Last und Ihr Wachstum abgestimmt.
Unsere Datenbank-Setups beginnen mit einem Indexierungs-Konzept, nicht mit einem Server. Wir analysieren echte Query-Patterns aus Slow-Logs, definieren passende Indizes, partitionieren große Tabellen und legen Read-Replicas dorthin, wo Reporting die Schreiblast bremsen würde. PostgreSQL und MySQL liefern wir mit konsistenten Connection-Pools (PgBouncer, ProxySQL) und vorbereiteten Statements - so bleibt p95-Latency auch unter Lastspitzen unter 50 ms.
Caching mit Redis oder Memcached setzen wir gezielt für Hot-Data ein - nicht pauschal, um echte Performance-Probleme nicht zu verdecken.
Datenbank-Sicherheit ist mehr als ein starkes Passwort. Wir setzen rollenbasierte Berechtigungen, Verschlüsselung at-rest und in-transit, Audit-Logs und automatische Rotation von Service-Account-Credentials. Backups laufen mit Point-in-Time-Recovery, werden in einer zweiten Region abgelegt und mindestens vierteljährlich aktiv wiederhergestellt. RTO und RPO sind keine Werte aus dem Vertrag, sondern getestete Größen aus echten Restore-Übungen.
Für regulierte Branchen liefern wir zusätzliche Logging-Layer für DSGVO-Auskunfts- und Löschprozesse - inklusive nachweisbarer Audit-Trails.
Wachstum bricht oft die Datenbank, lange bevor es die Anwendung bricht. Wir bauen Setups so, dass Sharding, Read-Replikation und Multi-Region-Failover ohne Migrations-Mega-Projekt nachrüstbar sind. Schema-Versionen laufen über reversible Migrationen, sodass Rollback jederzeit möglich bleibt. Wer heute 10.000 Anfragen pro Tag fährt und in 18 Monaten 1 Million erwartet, bekommt von uns das Setup, das beides ohne harten Cut trägt.
Sauber gesetzte Indizes, durchdachte Joins, vermiedene N+1-Queries und ein Datenmodell, das nicht erst beim ersten Lastpeak nachjustiert werden muss. Wir messen, bevor wir optimieren.
Partitionierung, Replikation, Read-Replicas, Connection-Pooling - wir denken Skalierung als Setup-Entscheidung, nicht als Krisen-Reaktion. Vertikal, wo es ausreicht; horizontal, wo es muss.
Backup-Strategien mit Recovery-Tests, Verschlüsselung im Ruhezustand, Audit-Trail-fähige Schema-Designs. Datenbanken, die Sie nicht jeden Monat neu erklären müssen.
Im Maintenance-Mode
Stabile Schemas, schnelle Queries und ein Setup, das auch nach Jahren noch wartbar ist - MARCODES liefert Datenbank-Architekturen aus zwanzig Jahren Praxis.
In vielen Anwendungen ist die Datenbank die Komponente, die zuerst an Grenzen stößt - lange bevor das Backend oder das Frontend ein Problem haben. Eine durchdachte Architektur und ein sauberes Datenmodell verhindern, dass jeder neue Use-Case ein neues Schema-Migrations-Drama wird. Bei MARCODES entwickeln wir Datenbank-Setups, die mit dem Geschäft mitwachsen - vom ersten MVP bis zu Milliarden Datensätzen.
Unsere Setups sind robust und gleichzeitig flexibel. Wir trennen operative von analytischen Workloads (OLTP versus OLAP), bauen Materialized Views, wo sie Reports beschleunigen, und setzen Caching-Schichten ein, wo Datenbanken sonst doppelte Arbeit machen müssten. Das gilt für klassische E-Commerce-Shops genauso wie für SaaS-Plattformen mit Multi-Tenancy oder für Energie- und Industrie-Anwendungen mit hochfrequenten Messdaten.
Datenbanken sind selten das, was beim Pitch begeistert, aber meistens das, woran ein Projekt später kippt. Wir bauen sie so, dass sie auch nach drei Jahren und einem Teamwechsel noch nachvollziehbar bleiben.
Jede Tabelle, jeder Index, jede Beziehung dokumentiert und begründet - kein „weil es schon immer so war“.
Wir profilen Queries, bevor wir tunen. Slow Query Logs, EXPLAIN-Pläne, gezielte Indizes.
Backup mit Recovery-Test, Verschlüsselung, Row-Level-Security, sauberer Audit-Trail.
Jeder Index aus einem Grund, jede Migration reversibel, jede Slow Query untersucht - statt ORM-Magie ohne Wartungsplan.
Wir bauen Datenbanken, die im Daily-Use ruhig laufen und im Notfall in einer Stunde wiederhergestellt sind.
Was wir bauen
Wählen Sie das passende Modell für Ihre Datenanforderungen - klein, mittel oder Enterprise-Setup mit Replikation und Sharding.
Jedes Projekt hat unterschiedliche Datenanforderungen, und deshalb bieten wir bei MARCODES eine flexible Datenbank-Entwicklung an, die genau auf Ihren Anwendungsfall zugeschnitten ist. Egal, ob Sie eine einfache OLTP-Datenbank für einen MVP oder eine Cluster-Architektur mit Read-Replicas, Connection-Pooling und Zeitreihen-Erweiterung benötigen - wir haben die passende Lösung.
Ein sauberes Datenmodell entscheidet später über Performance, Wartbarkeit und die Frage, ob ein Reporting in Sekunden oder Minuten antwortet. Wir modellieren Domain-Entitäten gemeinsam mit Ihnen, definieren Indizes mit Augenmaß und schreiben Migrationen, die sich auch in zwei Jahren noch reproduzierbar abspielen lassen.
Wo bestehende Strukturen aufgeräumt werden müssen, liefern wir vorher ein Schema-Audit - mit klarer Aussage zu Risiken, Refactoring-Schritten und Reihenfolge.
ab 4.900 € netto
Für Projekte mit MVP-Charakter.
Empfohlen
ab 12.900 € netto
Für Anwendungen mit hoher Last oder langsamen Berichten.
ab 29.900 € netto
Für Enterprise-Setups, Energie und PropTech mit großen Datenmengen.
Vom Issue zum Release
Sie brauchen ein neues Datenmodell, ein Performance-Tuning oder eine Migration? Wir haben die Lösung.
Vereinbaren Sie jetzt eine kostenfreie und unverbindliche Erstberatung. Wir helfen Ihnen, das passende Schema und die richtige Datenbank-Engine für Ihren Anwendungsfall zu finden und eine performante, sichere Architektur zu entwerfen. Ob frischer MVP-Start, Skalierungs-Problem oder Migration einer Bestands-Datenbank - wir stehen Ihnen zur Seite.
Wir hören zu, stellen die richtigen Fragen und liefern noch im Gespräch eine erste Einschätzung zu Engine-Wahl, Schema-Risiken und nächsten Schritten. Sie verlassen den Termin mit einer klaren Empfehlung, einem groben Aufwandsrahmen und der Sicherheit, ob ein vollständiges Schema-Audit oder direkt der Setup-Aufbau die bessere Reihenfolge ist. Kein Vertrieb, keine Pflicht zur Fortsetzung.
Engineering-Standard
Unsere Datenbank-Setups sind robust, sicher und auf Wachstum vorbereitet - für mehr Performance und weniger Operations-Drama.
Die Wahl der Datenbank-Engine und das Schema-Design entscheiden über die langfristigen Kosten einer Anwendung - sowohl bei der Wartung als auch im Betrieb. Eine gut gewählte Postgres-Instanz mit klugen Indizes kann jahrelang ohne Sondereinsatz laufen. Eine falsch gewählte oder schlecht modellierte Datenbank wird zum Dauerthema. Bei MARCODES sorgen wir dafür, dass diese Entscheidungen früh und durchdacht fallen.
Unsere Datenbank-Entwicklung ist darauf ausgelegt, sowohl die operativen Workloads als auch das Reporting performant zu halten. Wir trennen, wo Trennung Sinn ergibt (OLTP und OLAP), kombinieren, wo Kombination spart, und denken Backup-, Recovery- und Failover-Konzepte als integralen Bestandteil der Architektur - nicht als Nachgedanke vor dem Go-Live.
Was wir bauen
Datenbanken sind das Rückgrat moderner Anwendungen - hier einige interessante Fakten aus der Praxis.
Ein gut gesetzter Index kann eine Query von Sekunden auf Millisekunden bringen - oft, ohne dass sich am restlichen Code etwas ändert.
Diese Fakten zeigen, dass Datenbanken nicht nur passiv Daten halten, sondern aktiv über Erfolg oder Misserfolg einer Anwendung entscheiden. Mit einem Datenbank-Setup von MARCODES sind Sie auf hohe Lasten und langes Wachstum vorbereitet.
Saubere Schemas, dokumentierte Migrationsläufe, klare Backup- und Recovery-Strategien. Standards sind Standards.
Wir bauen Datenbanken nicht für unseren eigenen Use Case, sondern für alle, die in den nächsten Jahren damit arbeiten.
Tech-Stack offen
Neben Datenbank-Setups bieten wir vollständige Backend- und API-Entwicklung, damit die Datenstruktur auch produktiv erreichbar ist.
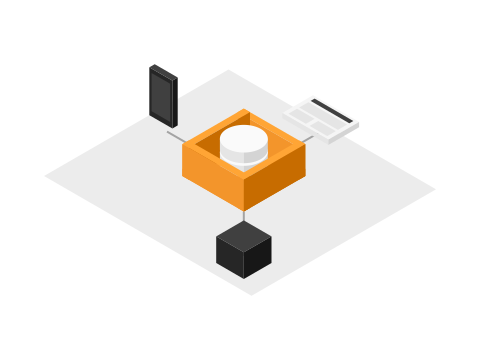
Wir entwickeln passende Backend-Services und APIs, die die Datenstruktur sauber kapseln und für Frontends, Partner oder Drittsysteme nutzbar machen. Dabei achten wir auf konsistente Vertragsdefinitionen, sauber dokumentierte Endpunkte und eine Architektur, die auch in fünf Jahren noch erweiterbar ist.
Ob Sie ein ERP- oder PIM-System anbinden wollen, ein Reporting-Backend brauchen oder eine Eigenentwicklung skalieren - unser Team hat die Erfahrung, Ihre Datenarchitektur und die zugehörigen Services aus einem Guss zu planen und zu betreiben. So entstehen Systeme, in denen das Datenbank-Setup und die Anwendungslogik nicht gegeneinander, sondern miteinander arbeiten.
Code-Realität
Vertrauen Sie auf MARCODES, um Ihre Datenarchitektur stabil, sicher und skalierbar zu gestalten.
Unsere Datenbanken sind nicht nur Speicher - sie sind die zentrale Schicht, die Ihr Geschäft messbar, auswertbar und automatisierbar macht. Mit einem Datenbank-Setup von MARCODES legen Sie die Basis für Reporting, Predictive-Maintenance, Multi-Tenancy oder schlicht für eine Anwendung, die mit der ersten Cohort genauso umgeht wie mit der hundertsten.
Egal, ob es um klassische OLTP-Workloads, Zeitreihen-Daten aus Smart-Metering oder Industrie, oder um eine Document-Store-Erweiterung für unstrukturierte Daten geht - unsere Datenbank-Setups passen sich Ihren Anforderungen an. Durch klare Operations-Konzepte und regelmäßige Backup-Tests sorgen wir dafür, dass Ihre Daten heute und in fünf Jahren ohne Sondereinsatz verfügbar sind.
Wir kennen die Stolpersteine beim Wechsel von MySQL zu Postgres und zurück.
Stack-Entscheidung
Wenn ein neues Datenbank-Setup allein nicht die Antwort ist, bieten wir weitere passende Leistungen.
Falls Ihre Anforderungen über das Datenbank-Setup hinausgehen, könnte eine unserer umfassenderen Leistungen die passendere Wahl sein. Vielleicht brauchen Sie eine sauber gebaute Schnittstelle oder API, um die Datenbank für andere Systeme nutzbar zu machen. Oder eine vollständige Webapp oder individuelle Software, die direkt auf Ihrem Datenmodell aufsetzt. Auch eine SaaS-Plattform kann der nächste Schritt sein, wenn aus dem Datenbank-Setup ein Produkt werden soll.
Sicherheits- oder Compliance-Aspekte bei sensiblen Daten? Unsere Leistung rund um Sicherheit & Compliance setzt die Standards. Für den sicheren Dauerbetrieb sorgt unser Hosting in deutschen Rechenzentren. Kontaktieren Sie uns, um die passende Lösung zu finden.
Schicken Sie uns ein paar Sätze zum Vorhaben. Wir antworten mit einer ehrlichen Einschätzung.